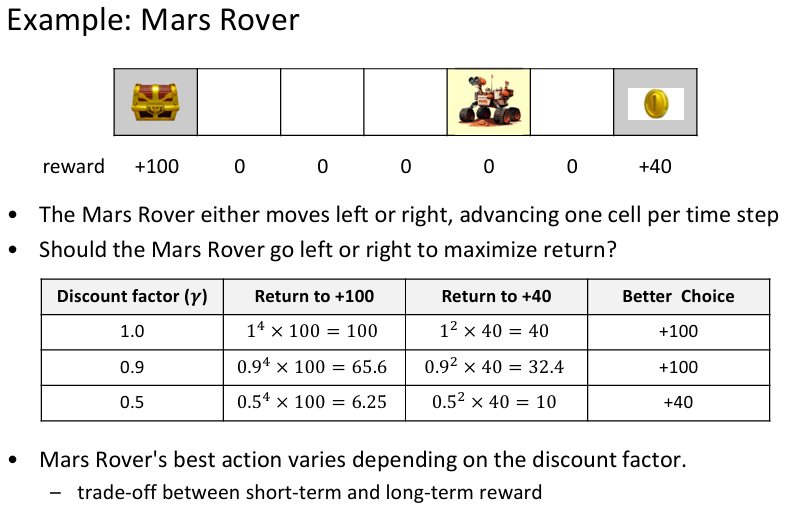

중간고사 공부를 한다. 강화학습이 해결해야 하는 4가지 질문 Q1. 어떻게 최적의 행동을 찾을 수 있을까? (lesson1~5)-> MDP, Bellman Equation, Dynamic Programming, Monte Carlo, TD Learning, BanditsQ2: 상태가 너무 많아지면 어떻게 할까? (lesson6~7)-> DQN, Policy Gradient, Actor-Critic, PPOQ3: 환경과 직접 상호작용하는 횟수를 어떻게 줄일까?Q4: 보상은 어디에서 오는 걸까? 용어정의 Markov Decision ProcessMarkov property: 미래는 현재 상태에만 의존하고 과거 상태에는 의존하지 않는다는 성질 Markov chain: Markov property를 만..