이어서 또 VLM 논문.
VLM 정말 재밌다. 뭔가 지금 모든 게 밝혀진 상태가 아니라서 그런지, 재밌게 연구할 분야가 무궁무진한 느낌이다.
CVPR 2026 논문이다.
https://vlm-mirage.github.io/static/pdfs/mirage_arxiv.pdf
Abstract
VLM은 멀티모달 이해 능력이 뛰어나지만 출력하는 과정에서는 텍스트만 생성하기 때문에 시각적인 추론 과정도 모두 언어로 표현해야 한다. 그래서 시각적 상상(visual imagination)이 필요한 문제에서는 성능이 비교적 안 나올 수 있다.
최근 연구들에서는 VLM이 실제 이미지를 생성하도록 학습시키기도 하지만, 이때 이미지 생성 사전학습이 필요하고(heavy함) 이게 오히려 추론 능력을 방해하는 경우가 있다.
그래서 인간이 어떻게 추론하는지에서 영감을 얻어서 Mirage 라는 Machine Mental Imagery 프레임워크를 제안한다.
인간은 머릿속에서 시각 정보를 만들고 조작하면서 사고한다. 이거를 굳이 그림으로 그리지 않아도 된다.
그래서 VLM도 이미지를 직접 생성하지 않고 interleaved multimodal trajectory를 통해서 추론할 수 있을지를 조사했다.
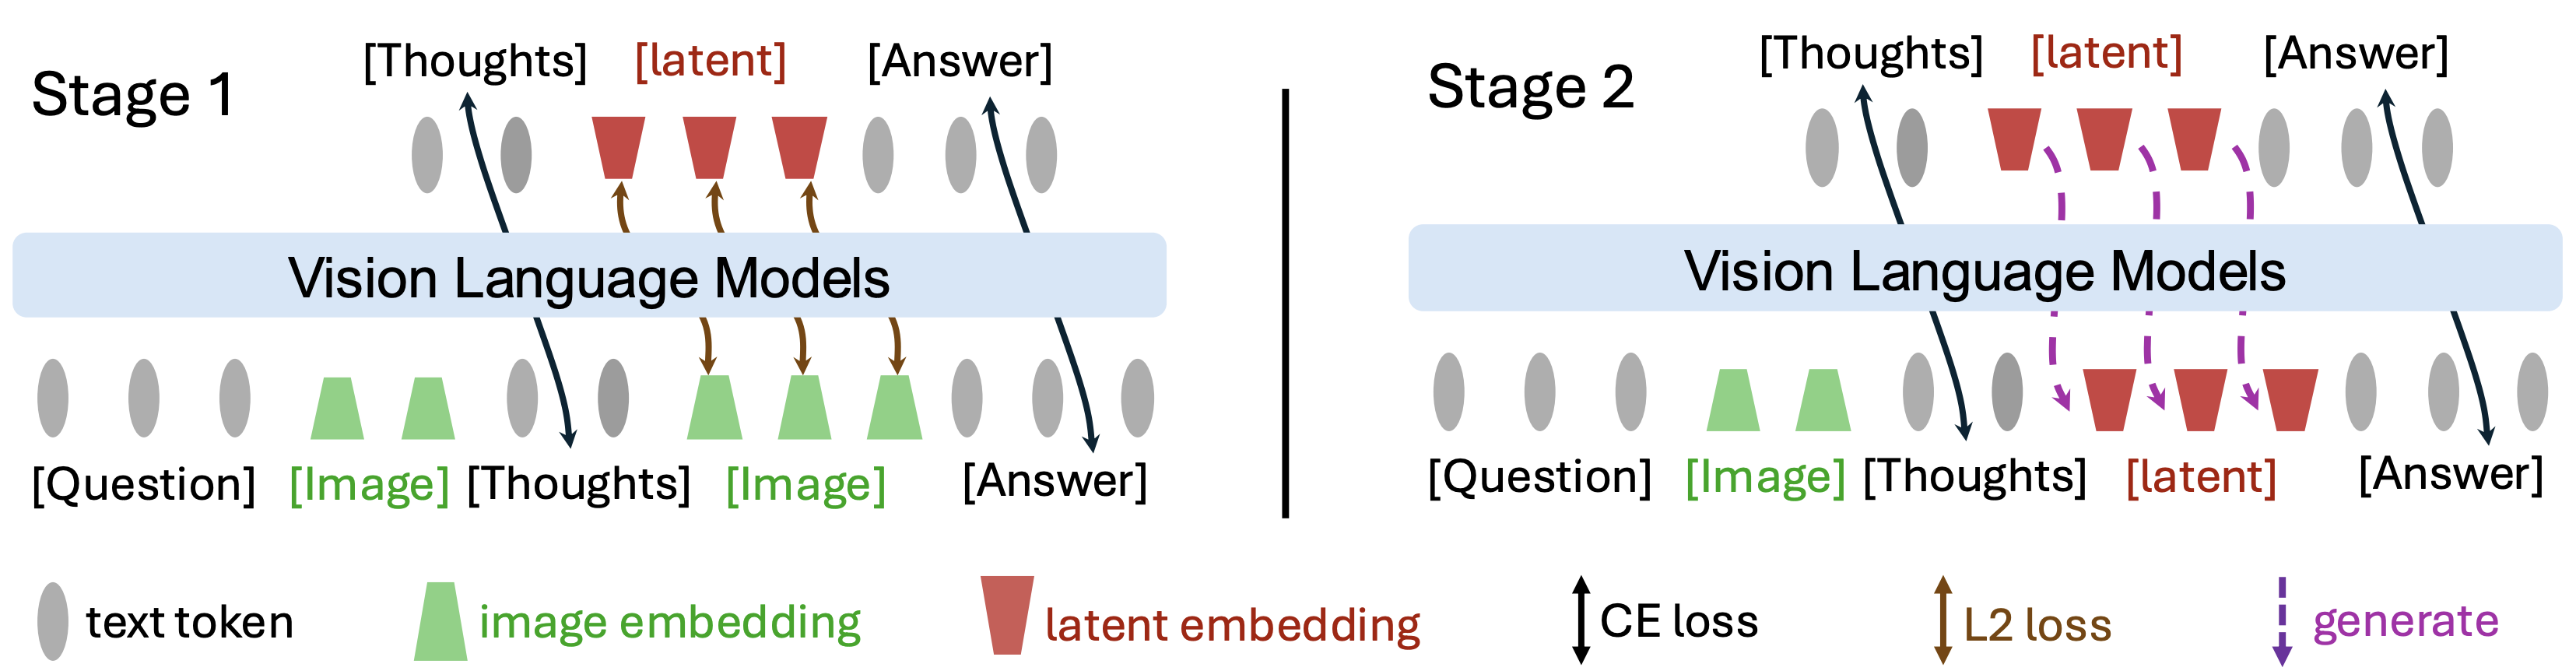
VLM decoding 과정에서 text token하고 같이 latent visual token도 사용할 수 있도록 한다.
구체적으로, 모델이 "think visually"를 선택하면 hidden state를 latent visual token 형태로 다음 decoding step에서 다시 사용한다.
먼저 ground-truth image embedding을 이용한 distillation을 통해서 latent token을 학습시킨다. 그 다음에 text-only supervision으로 바꿔서 latent reasoning trajectory가 실제 task의 목표랑 잘 맞도록 학습한다.
이후에 RL을 추가해서 multimodal 추론 능력을 더 향상시킨다.
그래서 이미지를 직접 생성하지 않고도 multimodal reasoning trajectory를 이어갈 수 있다.
1. Introduction
2. Related Work
2.1 Multimodal Chain-of-Thought
2.2 Latent Reasoning in LLMs
3. Multimodal Reasoning with Latent Visual Tokens
인간의 사고과과 비슷하게 VLM이 interleaved multimodal trajectory를 따라서 추론할 수 있게 하는 Mirage 프레임워크를 제안한다.
이미지 decoder를 두고 이미지 생성모델을 따로 pretrain한 기존의 모델들과 다르게 Mirage는 visual token 역할을 하는 compact한 latent embedding을 생성한다.
이미지 생성을 피해감으로써 정말 필요한 visual cue(인간이 reasoning 과정을 거치는 것처럼 간결하고 스케치 같은 표현)만 생성한다.
멀티모달 reasoning 데이터를 어떻게 합성하는지 먼저 설명하고, stage 1인 joint supervision training을 소개한 다음 latent 제약을 완화하면서 text-only supervision을 적용하는 stage2를 설명한다.
파이프라인은 아래와 같다.
3.1 Data Generation
하나 이상의 이미지랑 텍스트 query로 구성된 입력을 보고 VLM이 응답 $y$를 생성해야 하는 multimodal reasoning task를 생각해보자.
이제 간단하게 이미지랑 택스트를 모두 포함한 input을 x$로 표현하고자 한다.
VLM은 기본적으로 텍스트 토큰만 생성하기 때문에 텍스트랑 이미지가 섞인 interleaved reasoning pattern을 배우려면 추가적인 supervised fine-tuning이 필요하다.
그래서 입력 $x$에 대해서 task-specific helper image $I$를 짝지은 training corpus를 합성한다.
전체적인 데이터 생성 파이프라인은 아래와 같다.
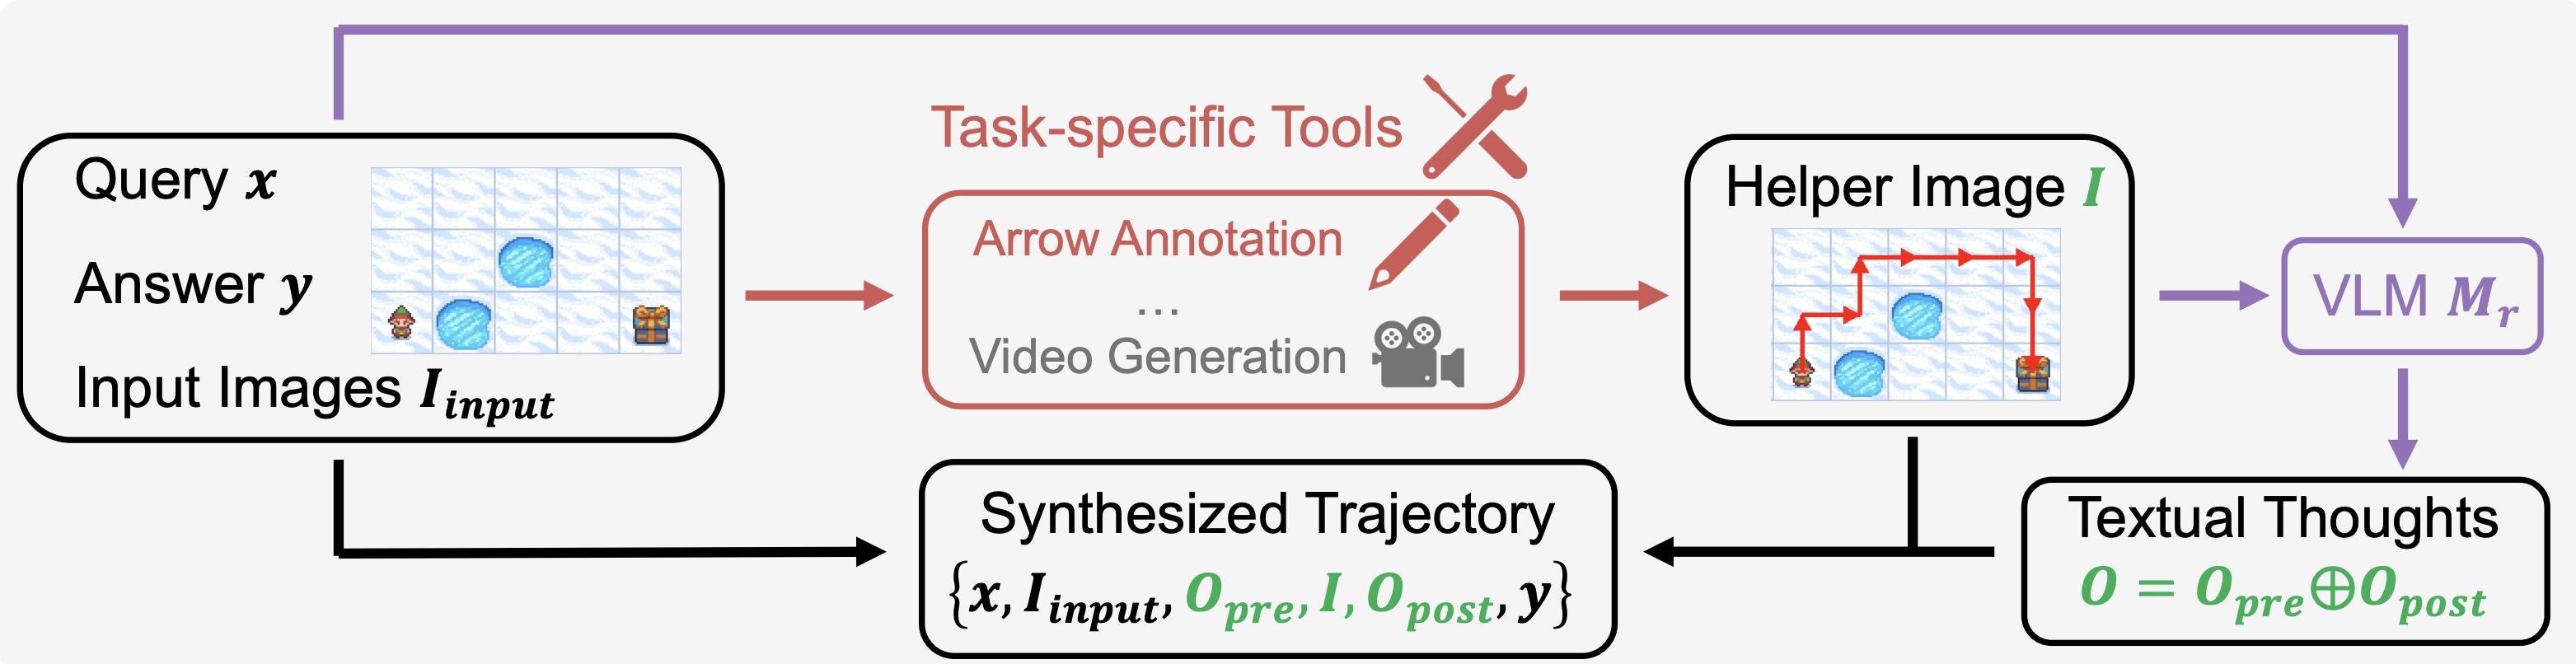
Task마다 helper imag를 생성하는 방법은 다르다. 위에 예시로 나온 네비게이션 task에서는 지도 위해 이동 경로를 직접 그려서 helper image를 만들었다. 그냥 정확한 visual cue를 담고 있도록 만들면 된다.
이렇게 helper image를 만든 다음에는 LLM이 이 helper image를 reasoning 과정에서 활용해서 최종 정답을 내도록 하는 reasoning chain을 합성한다.
Query $x$. answer $y$, helper image $I$를 VLM $M$에 넣어서 reasoning trajectory를 만든다.
"Generate a step-by-step reasoning that leads to the ground-truth answer while properly incorporating the helper image in reasoning.", 즉 helper image를 중간에 참고해서 정답까지 가는 풀이과정을 만들어달라는 식의 프롬프트를 넣을 수 있다.
그리고 모델 response를 $o = M(x,y,I)$라고 하자.
중간에 helper image가 들어오기 때문에 들어오는 시점을 기준으로 $o = o_{pre} \oplus I \oplus o_{post}$로 나타낼 수 있다.
이렇게 해서 나온 training dataset $D$는 $D = \{ x^{(i)}, I^{(i)}, o^{(i)}, y^{(i)} \}_{i=1}^{N}$로 나타낸다.
3.2 Joint Supervision for Latent Grounding
3.3 Text-Only Supervision with Latent Relaxation
3.4 Reinforcement Learning
4. Experiments
5. Analysis
6. Conclusion