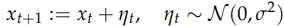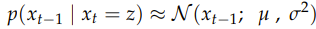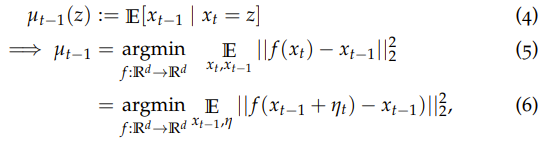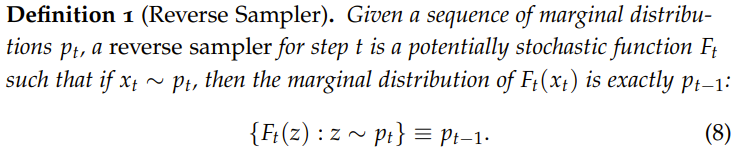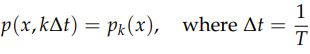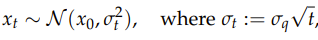Generative modeling의 목표는 미지의 분포 p*(x)에서 나온 i.i.d. 샘플들이 주어졌을 때, 이와 거의 같은 분포에서 새로운 샘플을 생성하는 샘플러를 만드는 것이다. 예를 들어서, p_dog 분포로부터 강아지 이미지 데이터가 주어졌을 때 이 분포로부터 새로운 강아지 이미지를 생성하는 방법을 원하는 것이다.
와 첫 문장부터 어렵다. 이게 무슨 소리람?
알고보니 '거의 같은 분포'라고 표현하는 이유는 그 분포를 정확히 알 수 없기 때문이다. 예를 들어서, 세상에 강아지 이미지는 무수히 많은데 우리가 가진 강아지 사진이 100만장인 경우이다. 강아지 사진이 유한개이므로 세상의 강아지 이미지가 어떤 확률로 나타나는지를 나타내는 실제 분포 p_{dog}를 정확히 알 수 없다.
이 문제를 해결하기 위한 한 가지 큰 방향은, 가우시안 노이즈처럼 샘플링하기 쉬운 분포를 목표 분포 p*로 변환하는 방법을 학습하는 것이다.
되게 clever한 방법이다. 완전한 노이즈에서 한 번에 강아지 이미지를 만드는 것은 어렵지 여러 번의 샘플링을 통해서 차차 강아지 이미지에 다가가는 것이 훨씬 쉽기 때문이다.
Diffusion 모델들은 이러한 변환을 학습하기 위한 general한 framework를 제공한다.
바로 다음에 나오는 gaussian diffusion 예제를 통해서 가장 잘 설명할 수 있다.
1.1 Gaussian Diffusion
가우시안 diffusion에서 R^d 차원의 확률변수 x_0가 있다고 하자. 뭐 앞에서 든 예시를 따라서 강아지 이미지라고 할 수 있다.
그 다음에 \eta_t ~ N(0, \sigma^2)인 \eta_t를 연속적으로 더해서 확률변수 $x_1, x_2, ..., x_T$를 만든다. 수식은 아래와 같다.
즉, $x_t = x_0 + \sum_{i=0}^{t-1} \eta_i$이다.
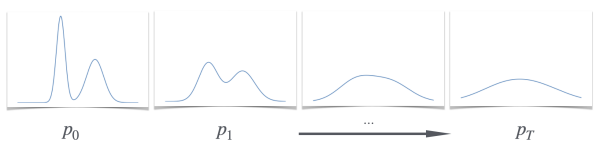
이 과정을 forward pass라고 한다. Data 분포를 노이즈 분포로 변환한다.
수식에서 $p(x_0, x_1, ..., x_T)$라는 결합분포를 정의할 수 있다.
그리고 특정 timestep t의 x_t만 따로 봤을 때의 주변분포를 p_t라고 한다.
T가 충분히 크면 p_T가 거의 가우시안이 됨을 알 수 있다. 그래서 그냥 가우시안 분포에서 샘플링하면 된다.
그림으로 나타내면 아래와 같다.
자, 이제 주변분포가 p_t인 샘플이 주어졌을 때, 주변분포가 p_{t-1}인 샘플을 만드는 문제를 해결할 수 있다고 가정하자.
이를 reverse sampler라고 부를 것이다.
Reverse sampler가 있다면 가우시안 샘플에서 시작해서 reverse sampling을 계속 적용해서 최종적으로 p_0=p*에서 샘플을 얻을 수 있을 것이다.
즉 핵심적인 통찰은, diffusion의 각 중간단계를 reverse하는 것이 목표 분포에서 함 번에 샘플링하는 것보다 쉬울 수 있다는 것이다!
여러 가지 방법이 있지만 먼저 일반적 diffusion sampler인 DDPM sampler 부터 보자.
이상적인 DDPM sampler는 가장 자연스러운 전략을 택한다.
시간 t에서 input z ~ p_t가 주어졌을 때, 조건부 분포 $p(x_{t-1} | x_t = z)$에서 샘플 하나를 출력한다.
이게 맞는 reverse sampler이긴 한데, 모든 x_t에 대해서 p(x_{t-1} | x_t)를 학습해야 하고 이게 엄청 복잡할 수 있다는 문제가 있다.
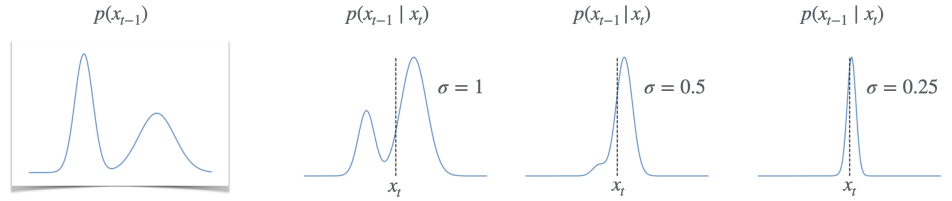
근데 만약에 한 step마다 추가하는 노이즈 \sigma가 엄청 작으면 이 조건부 분포가 단순해짐을 알 수 있다. x_t랑 x_{t-1}이 거의 같기 때문이다.
Fact1 (Diffusion Reverse Process). \sigma가 충분히 작고 식 $x_t = x_0 + \sum_{i=0}^{t-1} \eta_i$을 사용할 때, 조건부 분포 p(x_{t-1} | x_t)는 가우시안 분포에 가까워진다. 즉, 모든 시간 t랑 조건 z에 대해서 어떤 평균 벡터값 \mu가 존재한다. 수식으로 나타내면 아래와 같다.
유도는 2.1에서 할 것이다.
이 fact가 문제를 엄청나게 단순하게 만들어준다.
처음부터 임의의 분포 p(x_{t-1} | x_t) 전체를 학습하는 대신 이 분포의 평균만 알아내면 된다!
해당 분포에서 알아야하는 게 평균, 분산인데 분산이 \sigma^2임을 알았기 때문이다.
이 평균을 \mu_{t-1}(x_t)라고 쓰겠다.
\sigma가 충분히 작을 때 posterior를 가우시안으로 근사할 수 있다는 사실은 아래 그림에서 보여준다.
조건부 분포 p(x_{t-1} | x_t)의 평균 E[x_{t-1} | x_t]은 회귀로 구할 수 있다. (엥 어케 구함?)
이는 일반적인 regression loss를 최적화하는 방법으로 구할 수 있다.
수식으로 나타내면 아래와 같다.
\mu_{t-1}(z) := E[x_{t-1} | x_t = z]
: 현재 상태 x_t가 z라고 주어졌을 때, 그 이전 상태 x_{t-1}은 평균적으로 무엇이었을지를 \mu_{t-1}(z)라고 부르겠다.
f(x_t): AI가 예측한 사진, x_{t-1}: 한 단계 이전의 실제 상태. x_t보다 노이즈가 조금 덜 낀 데이터
-> f(x_t) - x_{t-1}: 오차
argmin: 가장 작은 값을 만드는 함수를 찾아라
=> \mu_{t-1} = argmin E|| f(x_t) - x_{t-1} ||^2: 평균 제곱 오차가 가장 작아지도록 함수 f를 학습하면 그 출력이 \mu_{t-1}가 된다!
이런 회귀 문제는 몇몇 분야에서 이미 잘 연구되어 있다.
만약에 목표 p*가 이미지에 대한 분포라면 해당 회귀 문제는 정확히 이미지 denoising 문제가 되고, CNN과 같은 익숙한 방법으로 해결할 수 있게 된다!
지금까지 한 이야기를 정리해보면,
우리는 지금 임의의 복잡한 분포에서 샘플을 생성하는 문제를 일반적인 회귀 문제로 바꾼 것이다!
1.2 Diffusions in the Abstract
이제 가우시안 세팅에서 벗어나서 다양한 diffusion-like 모델(e.g. deterministic samplers, discrete domains, flow-matching)을 포함할 수 있도록 추상적인 방식으로 정의해보자.
추상적으로 말하면 diffusion-like 생성모델을 다음과 같이 정의할 수 있다.
목표 분포 p*에서 시작하고, 샘플링하기 쉬운 기본 분포 q(x)를 하나 선택한다. (e.g. 가우시안, 비트)
그 다음에 p*랑 q(x)를 interpolate하는 분포 p_0, p_1, ..., p_T를 만든다. 여기서 p_0=p*이고, p_T=q(x)이다.